Một hệ thống SAN IBM DS3524 — 12 ổ SAS chạy suốt ngày đêm làm kho lưu trữ cho toàn bộ máy ảo VMware của doanh nghiệp — bỗng không cho máy chủ truy cập dữ liệu nữa. Nguyên nhân: mảng RAID 5 đã mất quá số ổ cho phép, và khi đó cơ chế chịu lỗi của RAID 5 không còn tác dụng.
Bên trong datastore là AD, ERP-SQL, Exchange, vCenter — xương sống vận hành của cả công ty. Đây là cách chúng tôi dựng lại mảng RAID ảo từ 12 ổ, đọc lại VMFS và lấy về 2.5TB dữ liệu máy ảo — cùng những việc bạn tuyệt đối không nên làm khi một mảng RAID báo lỗi nhiều ổ.
Tóm tắt nhanh
Thiết bị
Hệ thống lưu trữ SAN IBM/Lenovo DS3524
Dung lượng mỗi ổ
Khoảng 278GB/ổ
Nguyên nhân ban đầu
RAID 5 bị lỗi vượt quá số lượng ổ cứng cho phép
Tình trạng
Máy chủ không truy cập được dữ liệu máy ảo ổn định
Dữ liệu quan trọng
AD02, ERPSQL, EXMB01, EXMB02, WebCompany, vCenter và các thư mục máy ảo liên quan
Phương án xử lý
Kiểm tra từng ổ, dựng Virtual RAID, truy xuất VMFS, trích xuất dữ liệu máy ảo
Kết quả
Phục hồi được 2.5TB dữ liệu từ datastore VMFS
Tình trạng ban đầu
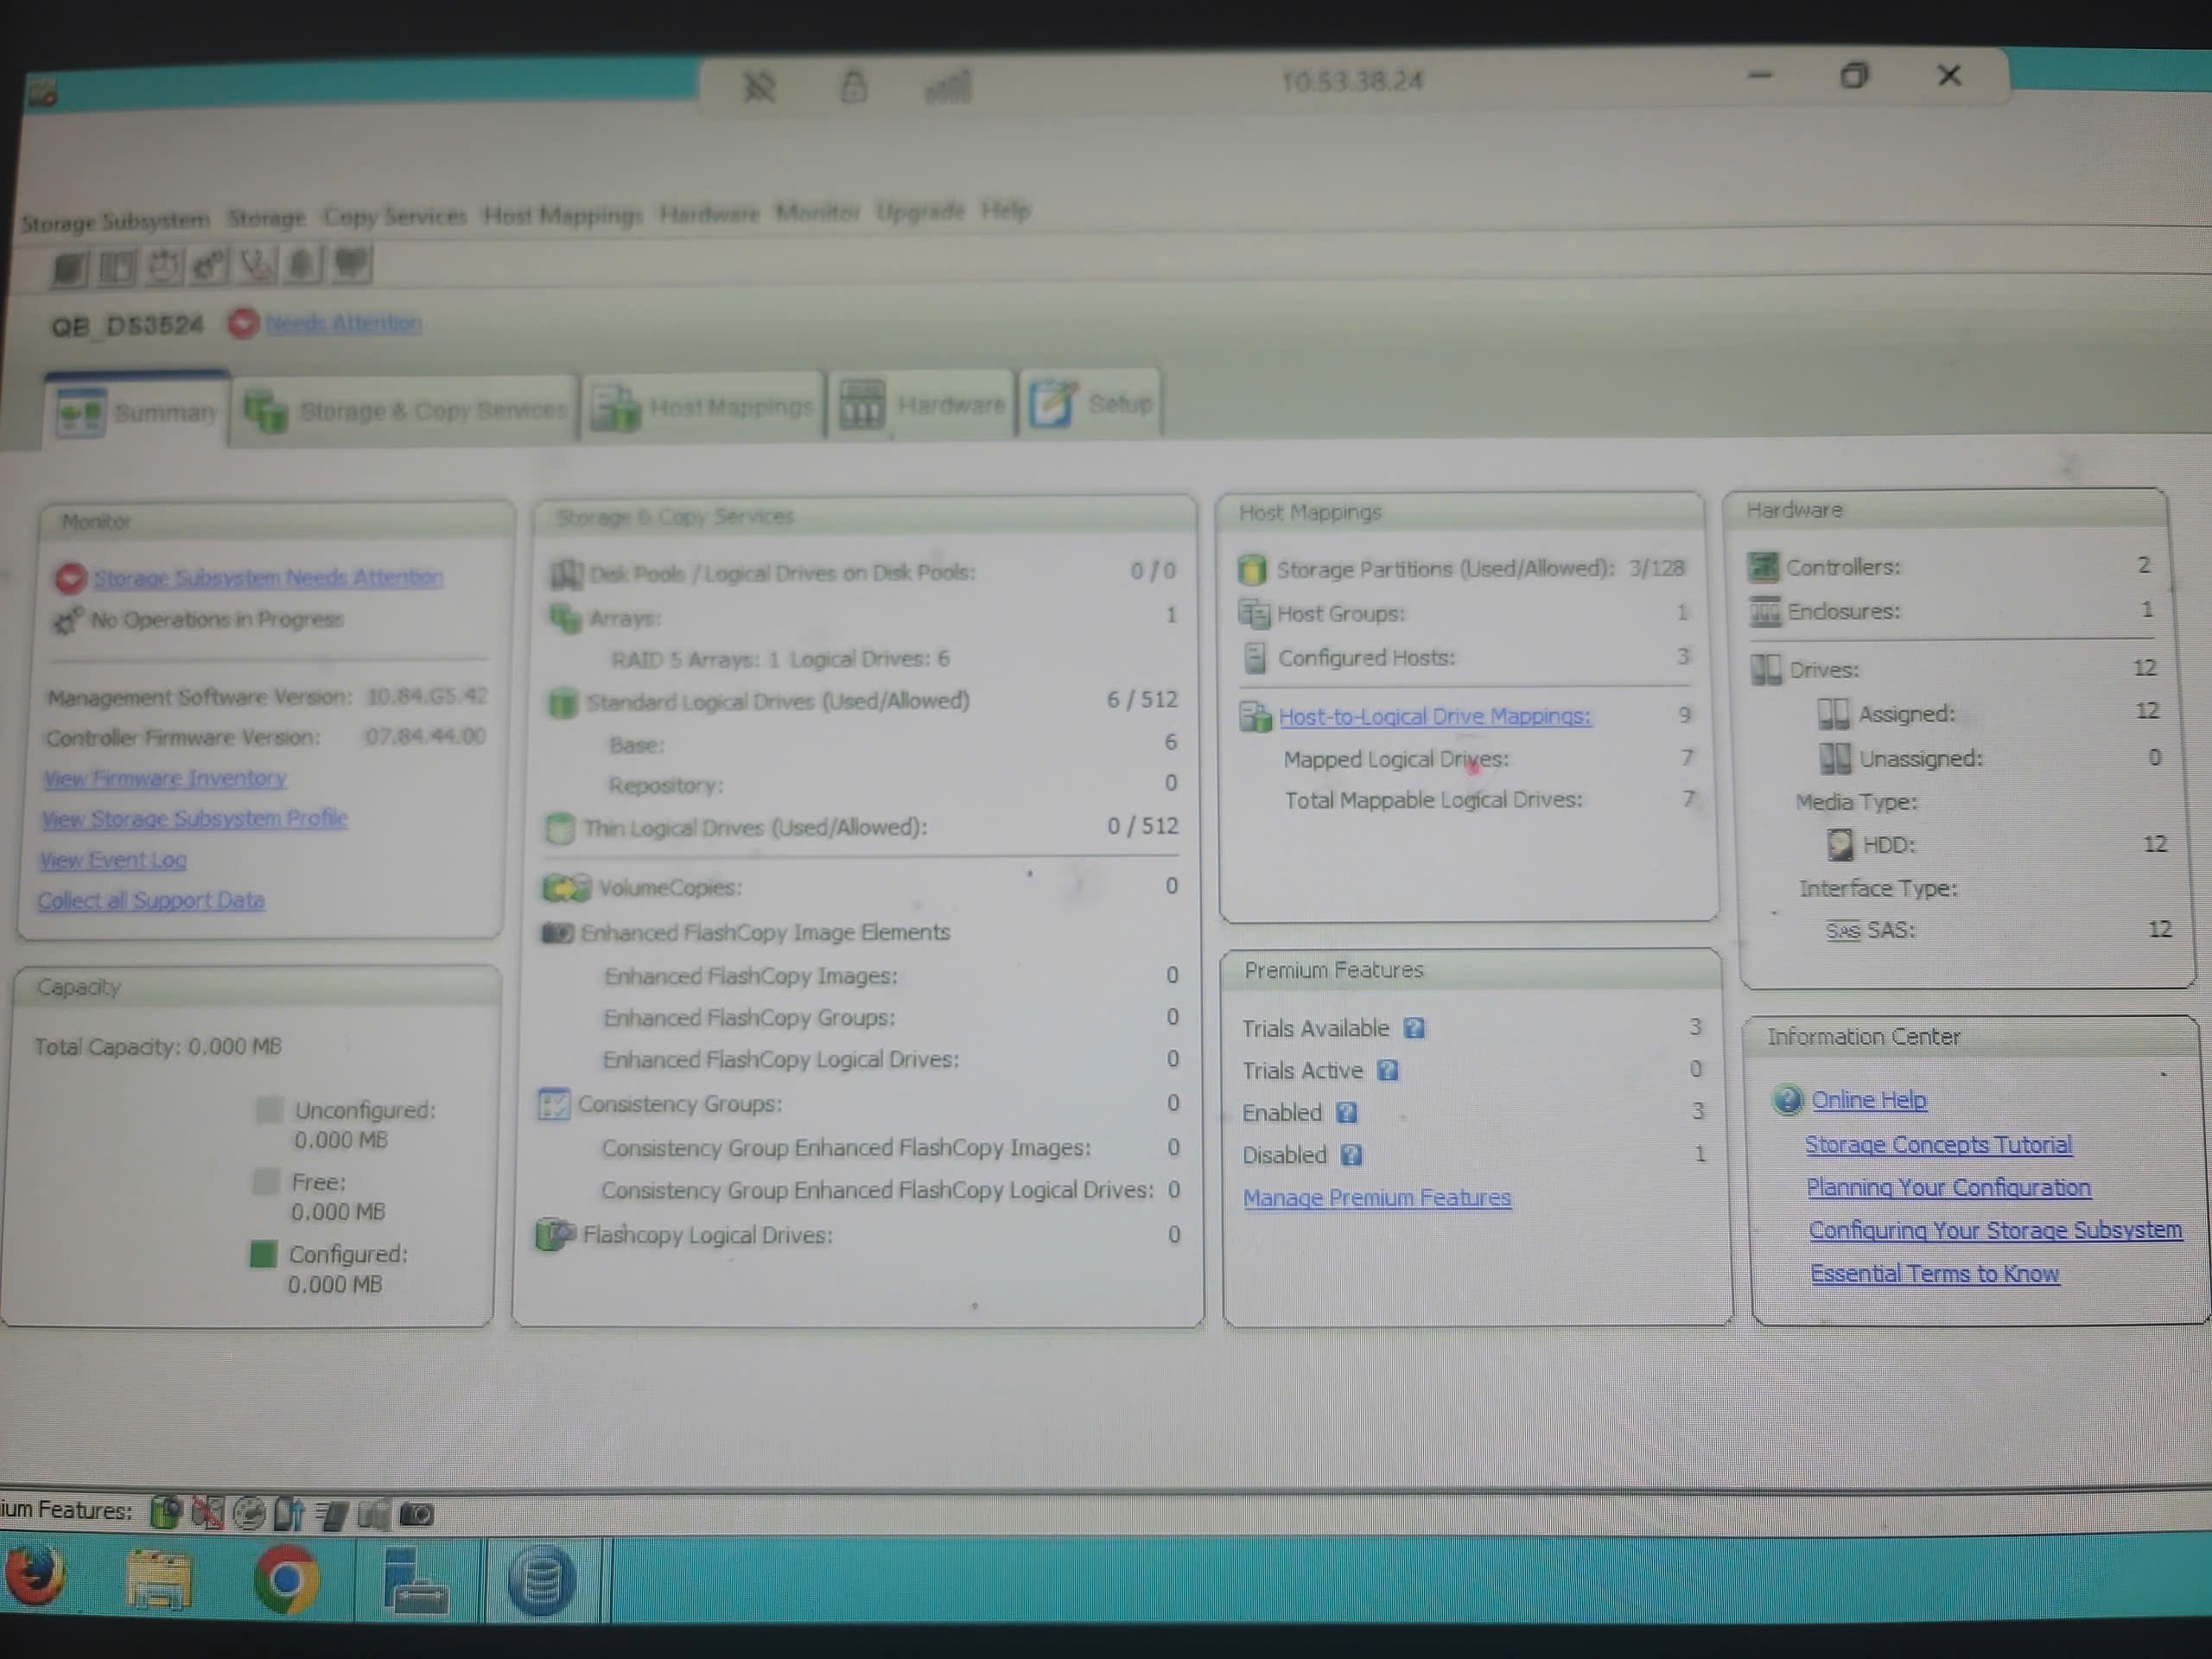
Khách hàng sử dụng hệ thống lưu trữ SAN DS3524 gồm 12 ổ cứng SAS 15K RPM, dung lượng mỗi ổ khoảng 278GB. Hệ thống này được dùng làm vùng lưu trữ cho môi trường máy ảo VMware.
Theo thông tin tiếp nhận, nguyên nhân ban đầu là RAID 5 bị lỗi vượt quá số lượng ổ cứng cho phép. Với RAID 5, hệ thống chỉ có khả năng chịu lỗi giới hạn. Khi số ổ lỗi vượt quá ngưỡng an toàn, toàn bộ mảng RAID có thể mất khả năng hoạt động bình thường.
Trên giao diện quản trị SAN, hệ thống hiển thị trạng thái cảnh báo. Trong quá trình phân tích, kỹ thuật viên ghi nhận có RAID 5 Array, nhiều Logical Drive và hệ thống lưu trữ được ánh xạ cho máy chủ.
Dữ liệu cần phục hồi nằm trong datastore VMFS tên DS_cluster. Sau khi dựng lại cấu trúc RAID ảo, datastore hiển thị các thư mục máy ảo như:
.vSphere-HAAD02CMC SourceERPSQLEXMB01EXMB02New Virtual MachineWebCompanyvCenter
Đây là nhóm dữ liệu có giá trị vận hành cao, liên quan đến hạ tầng máy ảo, máy chủ ứng dụng, SQL/ERP, email hoặc hệ thống quản trị nội bộ của doanh nghiệp.
Nguyên nhân sự cố
Nguyên nhân chính của case này là RAID 5 bị lỗi quá nhiều ổ cứng so với ngưỡng chịu lỗi cho phép.
Về nguyên lý, RAID 5 dùng cơ chế phân tán dữ liệu và parity trên nhiều ổ cứng. Khi một ổ lỗi, hệ thống vẫn có thể hoạt động nhờ parity. Tuy nhiên, nếu có thêm ổ lỗi, ổ đọc chậm, bad sector nặng hoặc ổ bị rớt khỏi mảng trong quá trình vận hành, RAID có thể không còn đủ dữ liệu để tự tái tạo.
Trong trường hợp này, dữ liệu không mất theo kiểu “xóa file” thông thường. Dữ liệu vẫn còn nằm rải rác trên các ổ SAS, nhưng hệ thống SAN không còn khả năng tự ghép đúng cấu trúc RAID để máy chủ VMware đọc được datastore VMFS.
Vì vậy, hướng xử lý không phải là chạy phần mềm quét từng ổ, mà phải:
- Xác định ổ nào còn hợp lệ.
- Kiểm tra ổ nào lỗi hoặc không đồng bộ.
- Phân tích metadata RAID.
- Dựng lại Virtual RAID.
- Truy xuất phân vùng VMFS.
- Trích xuất dữ liệu máy ảo ra thiết bị lưu trữ an toàn.
Vì sao case SAN 12 ổ này có độ phức tạp cao?
Với ổ cứng đơn, kỹ thuật viên có thể kiểm tra trực tiếp hệ thống tập tin như NTFS, FAT32, exFAT, EXT4 hoặc HFS+. Nhưng với SAN, dữ liệu không nằm độc lập trên từng ổ. Dữ liệu được chia thành các khối nhỏ và phân bố qua nhiều ổ cứng theo cấu hình RAID.
Trong case này, hệ thống sử dụng RAID 5. Điều này có nghĩa là dữ liệu và parity được phân bố trên nhiều ổ. Muốn truy xuất chính xác datastore VMFS, kỹ thuật viên phải xác định đúng:
- Thứ tự ổ cứng trong mảng RAID
- Block size
- Offset bắt đầu dữ liệu
- Cách xoay parity
- Ổ nào lỗi, ổ nào còn hợp lệ
- Logical Drive nào chứa datastore
- Phân vùng VMFS thật sự nằm ở vị trí nào
Nếu dựng sai một trong các thông số này, datastore có thể vẫn hiện nhưng file máy ảo bên trong sẽ lỗi, VMDK không mount được, VM không boot hoặc database bên trong bị hỏng.
RAID báo lỗi nhiều ổ — 3 việc tuyệt đối đừng làmĐừng bấm Rebuild hay Initialize, đừng tráo thứ tự ổ, và đừng ép mảng online lại nhiều lần. Mỗi thao tác sai trên một mảng RAID đã lỗi nặng có thể ghi đè đúng phần dữ liệu còn đọc được, hoặc xóa mất cấu hình cần để ghép lại. Việc đúng: giữ nguyên hiện trạng ổ đĩa và gọi đơn vị có kinh nghiệm RAID/SAN.
Rủi ro nếu xử lý sai
1. Rebuild RAID khi chưa xác định đúng ổ lỗi
Với RAID 5, hệ thống chỉ chịu lỗi trong giới hạn nhất định. Nếu rebuild khi có nhiều ổ đọc không ổn định hoặc chọn nhầm ổ để thay thế, parity mới có thể ghi đè lên dữ liệu cũ. Khi đó, khả năng phục hồi giảm mạnh.
2. Gán sai thứ tự ổ cứng
SAN 12 ổ không thể xử lý như 12 ổ độc lập. Nếu tháo ổ ra nhưng không đánh dấu vị trí, sau đó cắm lại sai bay, quá trình dựng lại RAID sẽ khó hơn. Một số hệ thống vẫn có metadata để nhận diện, nhưng không nên phụ thuộc hoàn toàn vào điều đó.
3. Initialize hoặc tạo lại Array
Nếu người dùng xóa array, tạo lại array mới hoặc initialize logical drive, metadata cũ có thể bị thay thế. Với hệ thống chứa VMFS, hành động này có thể làm mất cấu trúc datastore hoặc làm hỏng bảng ánh xạ dữ liệu máy ảo.
4. Chạy phần mềm cứu dữ liệu trên từng ổ riêng lẻ
Mỗi ổ chỉ chứa một phần dữ liệu. Quét từng ổ riêng lẻ thường không cho kết quả đúng với hệ thống RAID. Đặc biệt với VMFS, file VMDK có dung lượng lớn và có thể nằm phân tán trên toàn bộ mảng.
5. Mount trực tiếp datastore lên hệ thống đang lỗi
Nếu hệ thống vẫn đang bất ổn, việc cố mount, rescan, repair hoặc ghi thêm dữ liệu có thể làm thay đổi metadata. Trong phục hồi dữ liệu SAN, nguyên tắc an toàn là ưu tiên tạo bản sao trước khi phân tích chuyên sâu.
Nguyên nhân sự cố
Giải thích theo ngôn ngữ dễ hiểu
Hệ thống SAN hoạt động bằng cách gom nhiều ổ cứng lại thành một vùng lưu trữ lớn. Máy chủ VMware nhìn thấy vùng lưu trữ này như một datastore để chứa các máy ảo.
Khi SAN gặp lỗi, người dùng có thể thấy máy ảo mất kết nối, datastore không mount được, server không khởi động được hoặc file máy ảo biến mất. Thực tế, dữ liệu có thể vẫn còn trên các ổ cứng, nhưng hệ thống không còn đọc đúng cấu trúc RAID hoặc không truy cập đúng logical drive.
Giải thích kỹ thuật
Trong case này, dữ liệu nằm trên hệ thống RAID 5 gồm 12 ổ SAS. Lớp lưu trữ có nhiều tầng:
- Tầng vật lý: 12 ổ SAS 15K RPM.
- Tầng RAID: RAID 5 Array.
- Tầng Logical Drive: các LUN/Logical Drive được SAN cấp phát.
- Tầng host mapping: ánh xạ Logical Drive sang máy chủ.
- Tầng file system: VMFS datastore.
- Tầng máy ảo: thư mục VM chứa VMDK, VMX, NVRAM, snapshot nếu có.
- Tầng dữ liệu ứng dụng: SQL, file server, mail server hoặc phần mềm nội bộ.
Chỉ cần lỗi ở một tầng, toàn bộ hệ thống phía trên có thể không truy cập được.
Quy trình phân tích
Bước 1: Ghi nhận hiện trạng SAN
Kỹ thuật viên ghi nhận thông tin từ giao diện quản trị SAN:
- Model hệ thống: DS3524
- Số lượng controller: 2
- Số lượng enclosure: 1
- Số lượng ổ cứng: 12
- Chuẩn ổ: SAS
- Dung lượng mỗi ổ: khoảng 278.896GB
- Cấu hình: RAID 5 Array
- Logical Drive: nhiều logical drive đã được map
- Cảnh báo hệ thống: Storage Subsystem Needs Attention
Thông tin này giúp định hướng ban đầu nhưng chưa đủ để kết luận khả năng phục hồi. Cần kiểm tra trực tiếp dữ liệu trên từng ổ.
Bước 2: Đánh dấu và kiểm tra từng ổ cứng
Mỗi ổ được đánh dấu theo đúng vị trí bay ban đầu. Sau đó kiểm tra:
- Ổ còn nhận đúng model và dung lượng không
- Có lỗi đọc, bad sector hoặc timeout không
- Có ổ nào đọc chậm bất thường không
- Có ổ nào bị rớt khỏi RAID trước thời điểm sự cố không
- Metadata RAID trên từng ổ còn đồng nhất không
Với SAN dùng ổ SAS 15K, tốc độ quay cao nhưng tuổi thọ và tình trạng bad sector vẫn cần kiểm tra kỹ, đặc biệt khi hệ thống đã vận hành nhiều năm.
Bước 3: Tạo bản sao an toàn
Nguyên tắc xử lý là không thao tác trực tiếp trên ổ gốc. Các ổ cần được sao chép sector-by-sector hoặc image ra thiết bị lưu trữ an toàn.
Bước này giúp:
- Bảo vệ hiện trạng gốc
- Tránh làm ổ lỗi nặng hơn
- Cho phép phân tích RAID nhiều lần
- Giảm rủi ro ghi nhầm vào dữ liệu gốc
Trong các ca SAN/RAID, bản sao an toàn là điều kiện quan trọng trước khi dựng RAID ảo.
Bước 4: Phân tích metadata RAID
Kỹ thuật viên kiểm tra metadata trên từng ổ để xác định:
- Ổ thuộc array nào
- Thứ tự ổ trong RAID
- Offset bắt đầu
- Block size
- Parity rotation
- Logical Drive layout
- Ổ nào đang lỗi hoặc không đồng bộ
Với RAID 5, nếu một ổ bị lỗi, dữ liệu vẫn có thể dựng lại bằng parity. Nhưng nếu có nhiều ổ không đồng bộ hoặc metadata bị thay đổi, cần phân tích thủ công bằng công cụ chuyên dụng.
Bước 5: Dựng RAID ảo
Sau khi xác định thông số, hệ thống RAID được dựng lại dưới dạng Virtual RAID trên bản sao.
Kết quả phân tích cho thấy có thể nhận diện được phân vùng VMFS và datastore DS_cluster. Datastore này hiển thị các thư mục máy ảo quan trọng, cho thấy cấu trúc VMFS vẫn còn khả năng truy xuất.
Bước 6: Kiểm tra datastore VMFS
Datastore VMFS được kiểm tra ở cấp thư mục và file. Các dấu hiệu quan trọng gồm:
- Datastore mở được
- Thư mục máy ảo hiển thị đúng tên
- Có file hệ thống VMFS như .fbb.sf, .fdc.sf, .pb2.sf, .pbc.sf, .sbc.sf, .vh.sf
- Có thư mục máy ảo theo tên dịch vụ
- Ngày tháng file/thư mục hợp lý
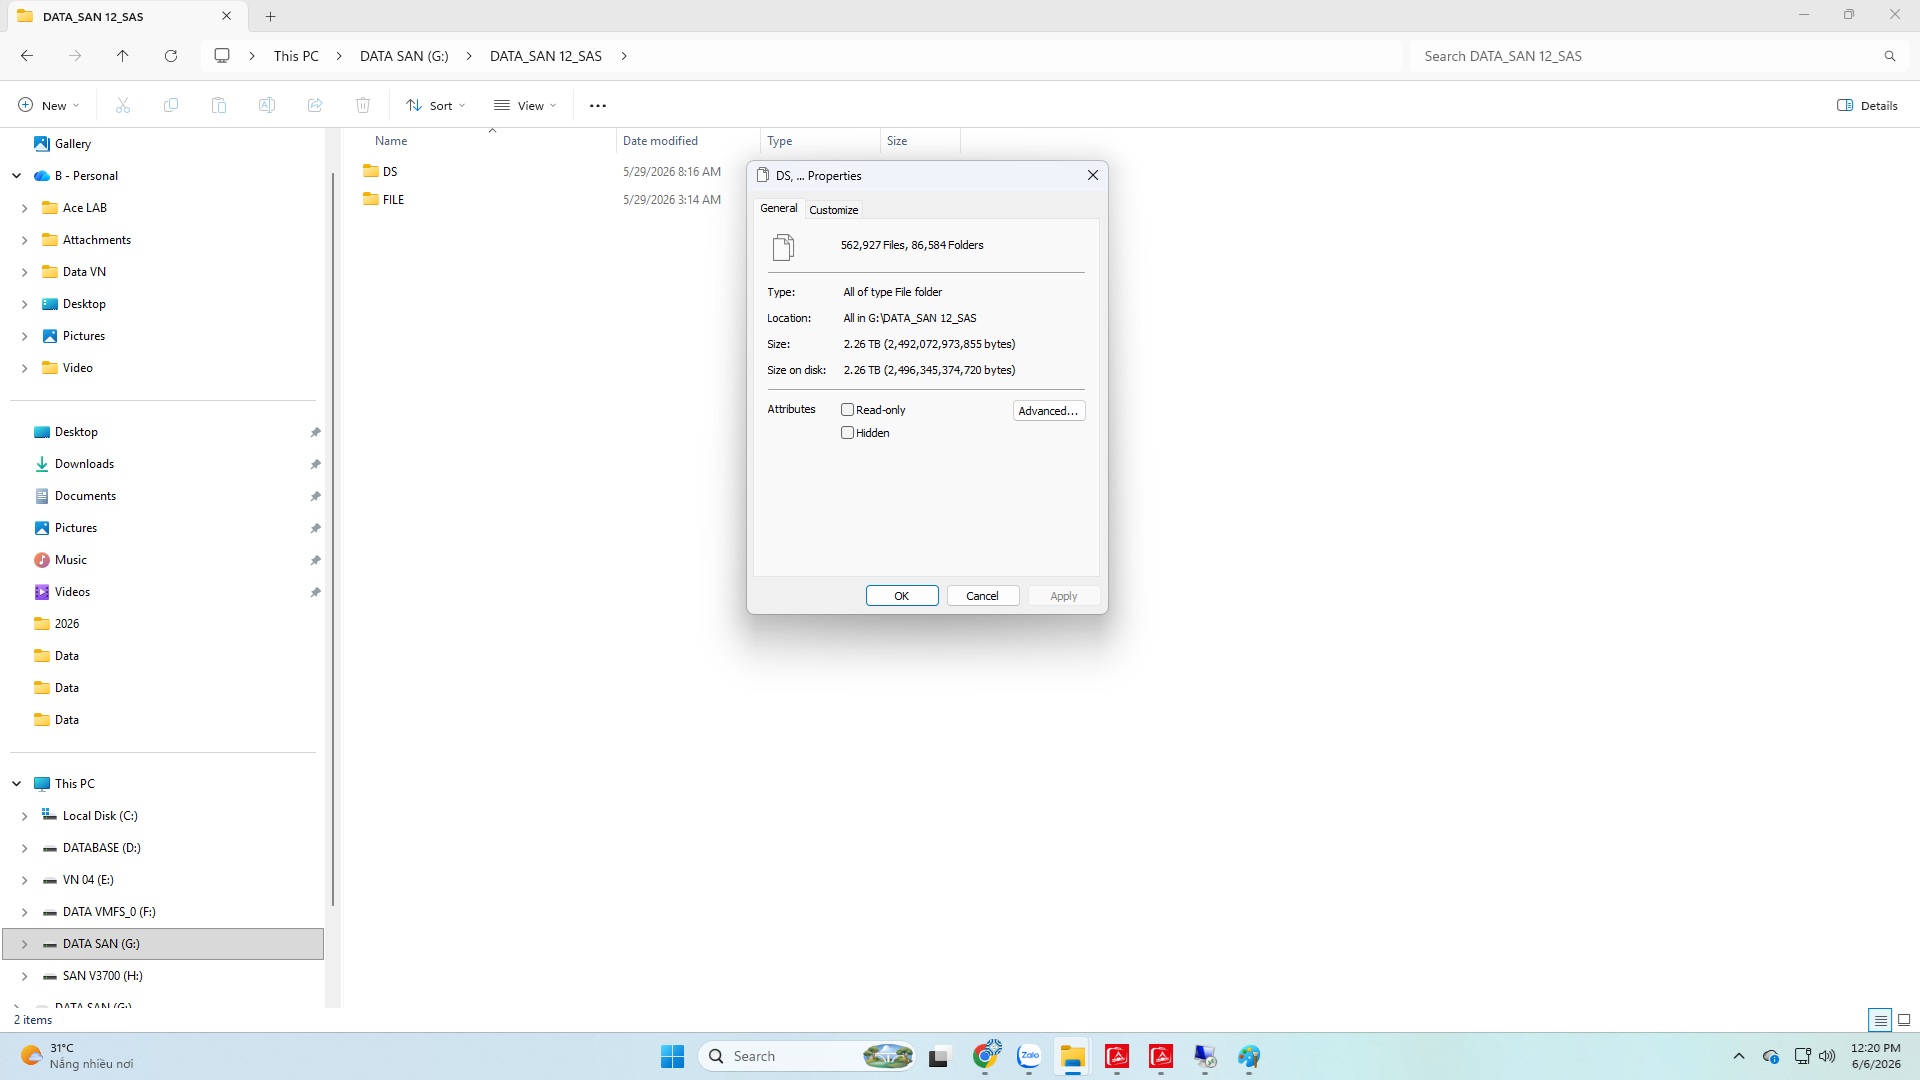
- Dung lượng phân vùng VMFS hiển thị khoảng 1.46TB
Việc thấy được thư mục máy ảo là tín hiệu tốt, nhưng chưa phải kết luận cuối cùng. Cần kiểm tra tiếp từng file VMDK và dữ liệu bên trong máy ảo.
Bước 7: Trích xuất dữ liệu ưu tiên
Dữ liệu được ưu tiên theo mức độ quan trọng vận hành:
- Máy ảo Active Directory hoặc domain controller.
- Máy ảo SQL hoặc ERP.
- Máy ảo Exchange hoặc hệ thống mail.
- Máy ảo vCenter.
- Máy ảo web hoặc file server.
- Dữ liệu phụ trợ còn lại.
Trong case này, các thư mục như AD02, ERPSQL, EXMB01, EXMB02, WebCompany và vCenter cần được kiểm tra trước vì có khả năng liên quan đến hạ tầng lõi của doanh nghiệp.
Quy trình xử lý theo trình tự
Ngày 1: Tiếp nhận và đánh giá hiện trạng
- Tiếp nhận 12 ổ cứng SAS từ hệ thống SAN.
- Ghi nhận model SAN DS3524.
- Kiểm tra ảnh chụp giao diện quản trị.
- Xác định hệ thống đang có cảnh báo Needs Attention.
- Ghi nhận RAID 5 Array và Logical Drive đang tồn tại.
- Xác định dữ liệu cần ưu tiên là datastore VMware VMFS.
Ngày 2: Kiểm tra ổ và tạo bản sao
- Đánh dấu thứ tự từng ổ.
- Kiểm tra tình trạng đọc của 12 ổ.
- Image từng ổ sang thiết bị lưu trữ an toàn.
- Ghi nhận ổ đọc chậm, lỗi sector hoặc ổ không đồng bộ nếu có.
- Bảo toàn ổ gốc để tránh phát sinh lỗi mới.
Ngày 3: Phân tích RAID
- Đọc metadata RAID từ từng ổ.
- So sánh thông tin array.
- Xác định thứ tự ổ, block size, offset và parity.
- Dựng RAID ảo.
- Kiểm tra các Logical Drive được tạo trên SAN.
Ngày 4: Truy xuất VMFS
- Tìm phân vùng VMFS.
- Mount datastore DS_cluster trên môi trường phân tích.
- Kiểm tra cấu trúc thư mục máy ảo.
- Ghi nhận các thư mục AD02, ERPSQL, EXMB01, EXMB02, WebCompany, vCenter.
- Kiểm tra sơ bộ file hệ thống VMFS.
Ngày 5: Trích xuất và kiểm tra dữ liệu
- Trích xuất dữ liệu máy ảo theo nhóm ưu tiên.
- Kiểm tra tính toàn vẹn file VMDK.
- Kiểm tra file cấu hình VMX.
- Nếu có database, kiểm tra thêm khả năng mount/attach ở tầng ứng dụng.
- Lập báo cáo kỹ thuật và bàn giao dữ liệu theo kết quả thực tế.
Kết quả phục hồi
Sau quá trình phân tích, kỹ thuật viên dựng lại được cấu trúc RAID ảo và truy xuất được phân vùng VMFS của datastore DS_cluster.
Các thư mục máy ảo hiển thị gồm:
- .vSphere-HA
- AD02
- CMC Source
- ERPSQL
- EXMB01
- EXMB02
- New Virtual Machine
- WebCompany
- vCenter
Ngoài ra, datastore còn hiển thị các file hệ thống VMFS như:
- .fbb.sf
- .fdc.sf
- .pb2.sf
- .pbc.sf
- .sbc.sf
- .vh.sf
Điều này cho thấy lớp file system VMFS còn có thể phân tích được. Tuy nhiên, với dữ liệu máy ảo, cần kiểm tra sâu thêm từng file VMDK và dữ liệu bên trong máy ảo để xác nhận mức độ toàn vẹn cuối cùng.
Kết quả nên được chia làm 3 nhóm khi bàn giao:
Nhóm 1: Máy ảo có thể khôi phục và kiểm tra được
Đây là nhóm thư mục VM có file VMDK, VMX còn đủ cấu trúc, có thể mở hoặc mount để kiểm tra dữ liệu bên trong.
Nhóm 2: Máy ảo cần kiểm tra bổ sung
Đây là nhóm có dữ liệu nhưng cần kiểm tra thêm snapshot, chain VMDK, lỗi descriptor hoặc lỗi ứng dụng bên trong.
Nhóm 3: Dữ liệu bị ảnh hưởng bởi lỗi ổ hoặc lỗi RAID
Đây là nhóm file có thể bị thiếu block, lỗi sector, lỗi parity hoặc lỗi không đồng bộ. Cần xử lý riêng theo từng máy ảo.
Nhận xét chuyên gia
Theo góc nhìn kỹ thuật, case SAN DS3524 RAID 5 gồm 12 ổ SAS này có điểm đáng chú ý là dữ liệu không chỉ nằm ở tầng RAID mà còn nằm trong datastore VMFS của VMware.
Với hệ thống ảo hóa, việc nhìn thấy thư mục máy ảo chưa đủ để kết luận dữ liệu đã an toàn. Một máy ảo có thể có nhiều file VMDK, snapshot, descriptor, file cấu hình VMX và dữ liệu ứng dụng bên trong. Nếu chỉ copy thư mục ra mà không kiểm tra, khi khách hàng import lại vào VMware có thể gặp lỗi không boot, mất snapshot chain hoặc database bên trong không mở được.
Đối với SAN doanh nghiệp, thao tác xử lý cần theo thứ tự:
- Bảo toàn ổ gốc.
- Image toàn bộ ổ.
- Phân tích metadata RAID.
- Dựng RAID ảo.
- Mount VMFS ở chế độ an toàn.
- Trích xuất máy ảo.
- Kiểm tra dữ liệu bên trong máy ảo.
Điểm rủi ro lớn nhất là người dùng tự rebuild hoặc tạo lại cấu hình khi chưa xác định đúng nguyên nhân. Với RAID 5, một thao tác rebuild sai có thể làm dữ liệu thay đổi trên toàn mảng. Dấu hiệu nhận biết sớm hệ thống SAN có nguy cơ mất dữ liệu
Doanh nghiệp cần kiểm tra ngay nếu gặp các dấu hiệu sau:
- Storage Subsystem báo Needs Attention.
- Một hoặc nhiều ổ báo lỗi đỏ/vàng.
- Host không truy cập được LUN.
- Datastore VMware bị mất hoặc không mount.
- Máy ảo đang chạy bỗng tắt bất thường.
- vCenter báo mất datastore.
- Tốc độ truy cập máy ảo chậm bất thường.
- Có cảnh báo controller, enclosure hoặc logical drive.
- RAID đang degraded nhưng chưa xác định nguyên nhân.
- Rebuild RAID chạy chậm, treo hoặc failed.
FAQ – Câu hỏi thường gặp
1. SAN RAID 5 hỏng có cứu dữ liệu được không?
Có thể kiểm tra và phục hồi trong nhiều trường hợp, nhưng kết quả phụ thuộc vào số ổ lỗi, mức độ bad sector, tình trạng metadata RAID và việc hệ thống đã bị rebuild hoặc initialize chưa.
2. RAID 5 12 ổ hỏng mấy ổ thì mất dữ liệu?
RAID 5 thường chịu lỗi một ổ. Nếu có nhiều hơn một ổ lỗi hoặc có ổ lỗi âm thầm trước đó, hệ thống có thể mất khả năng truy cập. Tuy nhiên, vẫn cần phân tích thực tế vì có trường hợp ổ lỗi không hoàn toàn hoặc còn đọc được một phần.
3. Vì sao thấy thư mục máy ảo rồi vẫn chưa thể kết luận phục hồi hoàn tất?
Vì máy ảo VMware gồm nhiều thành phần như VMDK, VMX, snapshot, NVRAM và dữ liệu ứng dụng bên trong. Cần kiểm tra từng file và thử mount/boot hoặc kiểm tra database mới đánh giá được tính toàn vẹn.
4. Có nên cắm lại ổ vào SAN rồi rebuild không?
Không nên nếu chưa xác định đúng nguyên nhân. Rebuild sai có thể ghi đè dữ liệu và làm giảm khả năng phục hồi.
5. Có thể quét từng ổ SAS bằng phần mềm cứu dữ liệu thông thường không?
Không nên. Mỗi ổ chỉ chứa một phần dữ liệu của RAID. Phải dựng đúng RAID ảo rồi mới truy xuất đúng datastore VMFS.
6. VMFS là gì?
VMFS là hệ thống tập tin của VMware dùng để lưu trữ máy ảo trên datastore. Trong case này, datastore DS_cluster chứa nhiều thư mục máy ảo của doanh nghiệp.
7. Khi SAN báo Needs Attention cần làm gì đầu tiên?
Nên dừng các thao tác ghi dữ liệu, chụp lại trạng thái cảnh báo, ghi nhận thứ tự ổ và liên hệ kỹ thuật có kinh nghiệm về SAN/RAID/VMware.
8. Chi phí cứu dữ liệu SAN 12 ổ được tính thế nào?
Chi phí phụ thuộc vào số lượng ổ, dung lượng, tình trạng vật lý từng ổ, loại RAID, mức độ lỗi metadata, có cần phục hồi máy ảo hoặc database bên trong hay không. Với hệ thống doanh nghiệp, cần kiểm tra thực tế trước khi báo giá chính xác.
9. Có thể phục hồi riêng một máy ảo quan trọng trước không?
Có thể, nếu datastore VMFS còn truy xuất được và file của máy ảo đó còn đủ cấu trúc. Thông thường sẽ ưu tiên domain controller, SQL/ERP, email server, file server hoặc vCenter trước.
10. Sau khi phục hồi xong có cần kiểm tra máy ảo không?
Có. Cần kiểm tra file VMDK, cấu hình VMX, khả năng boot, dữ liệu ứng dụng bên trong và tính nhất quán của database nếu có.
Kết luận
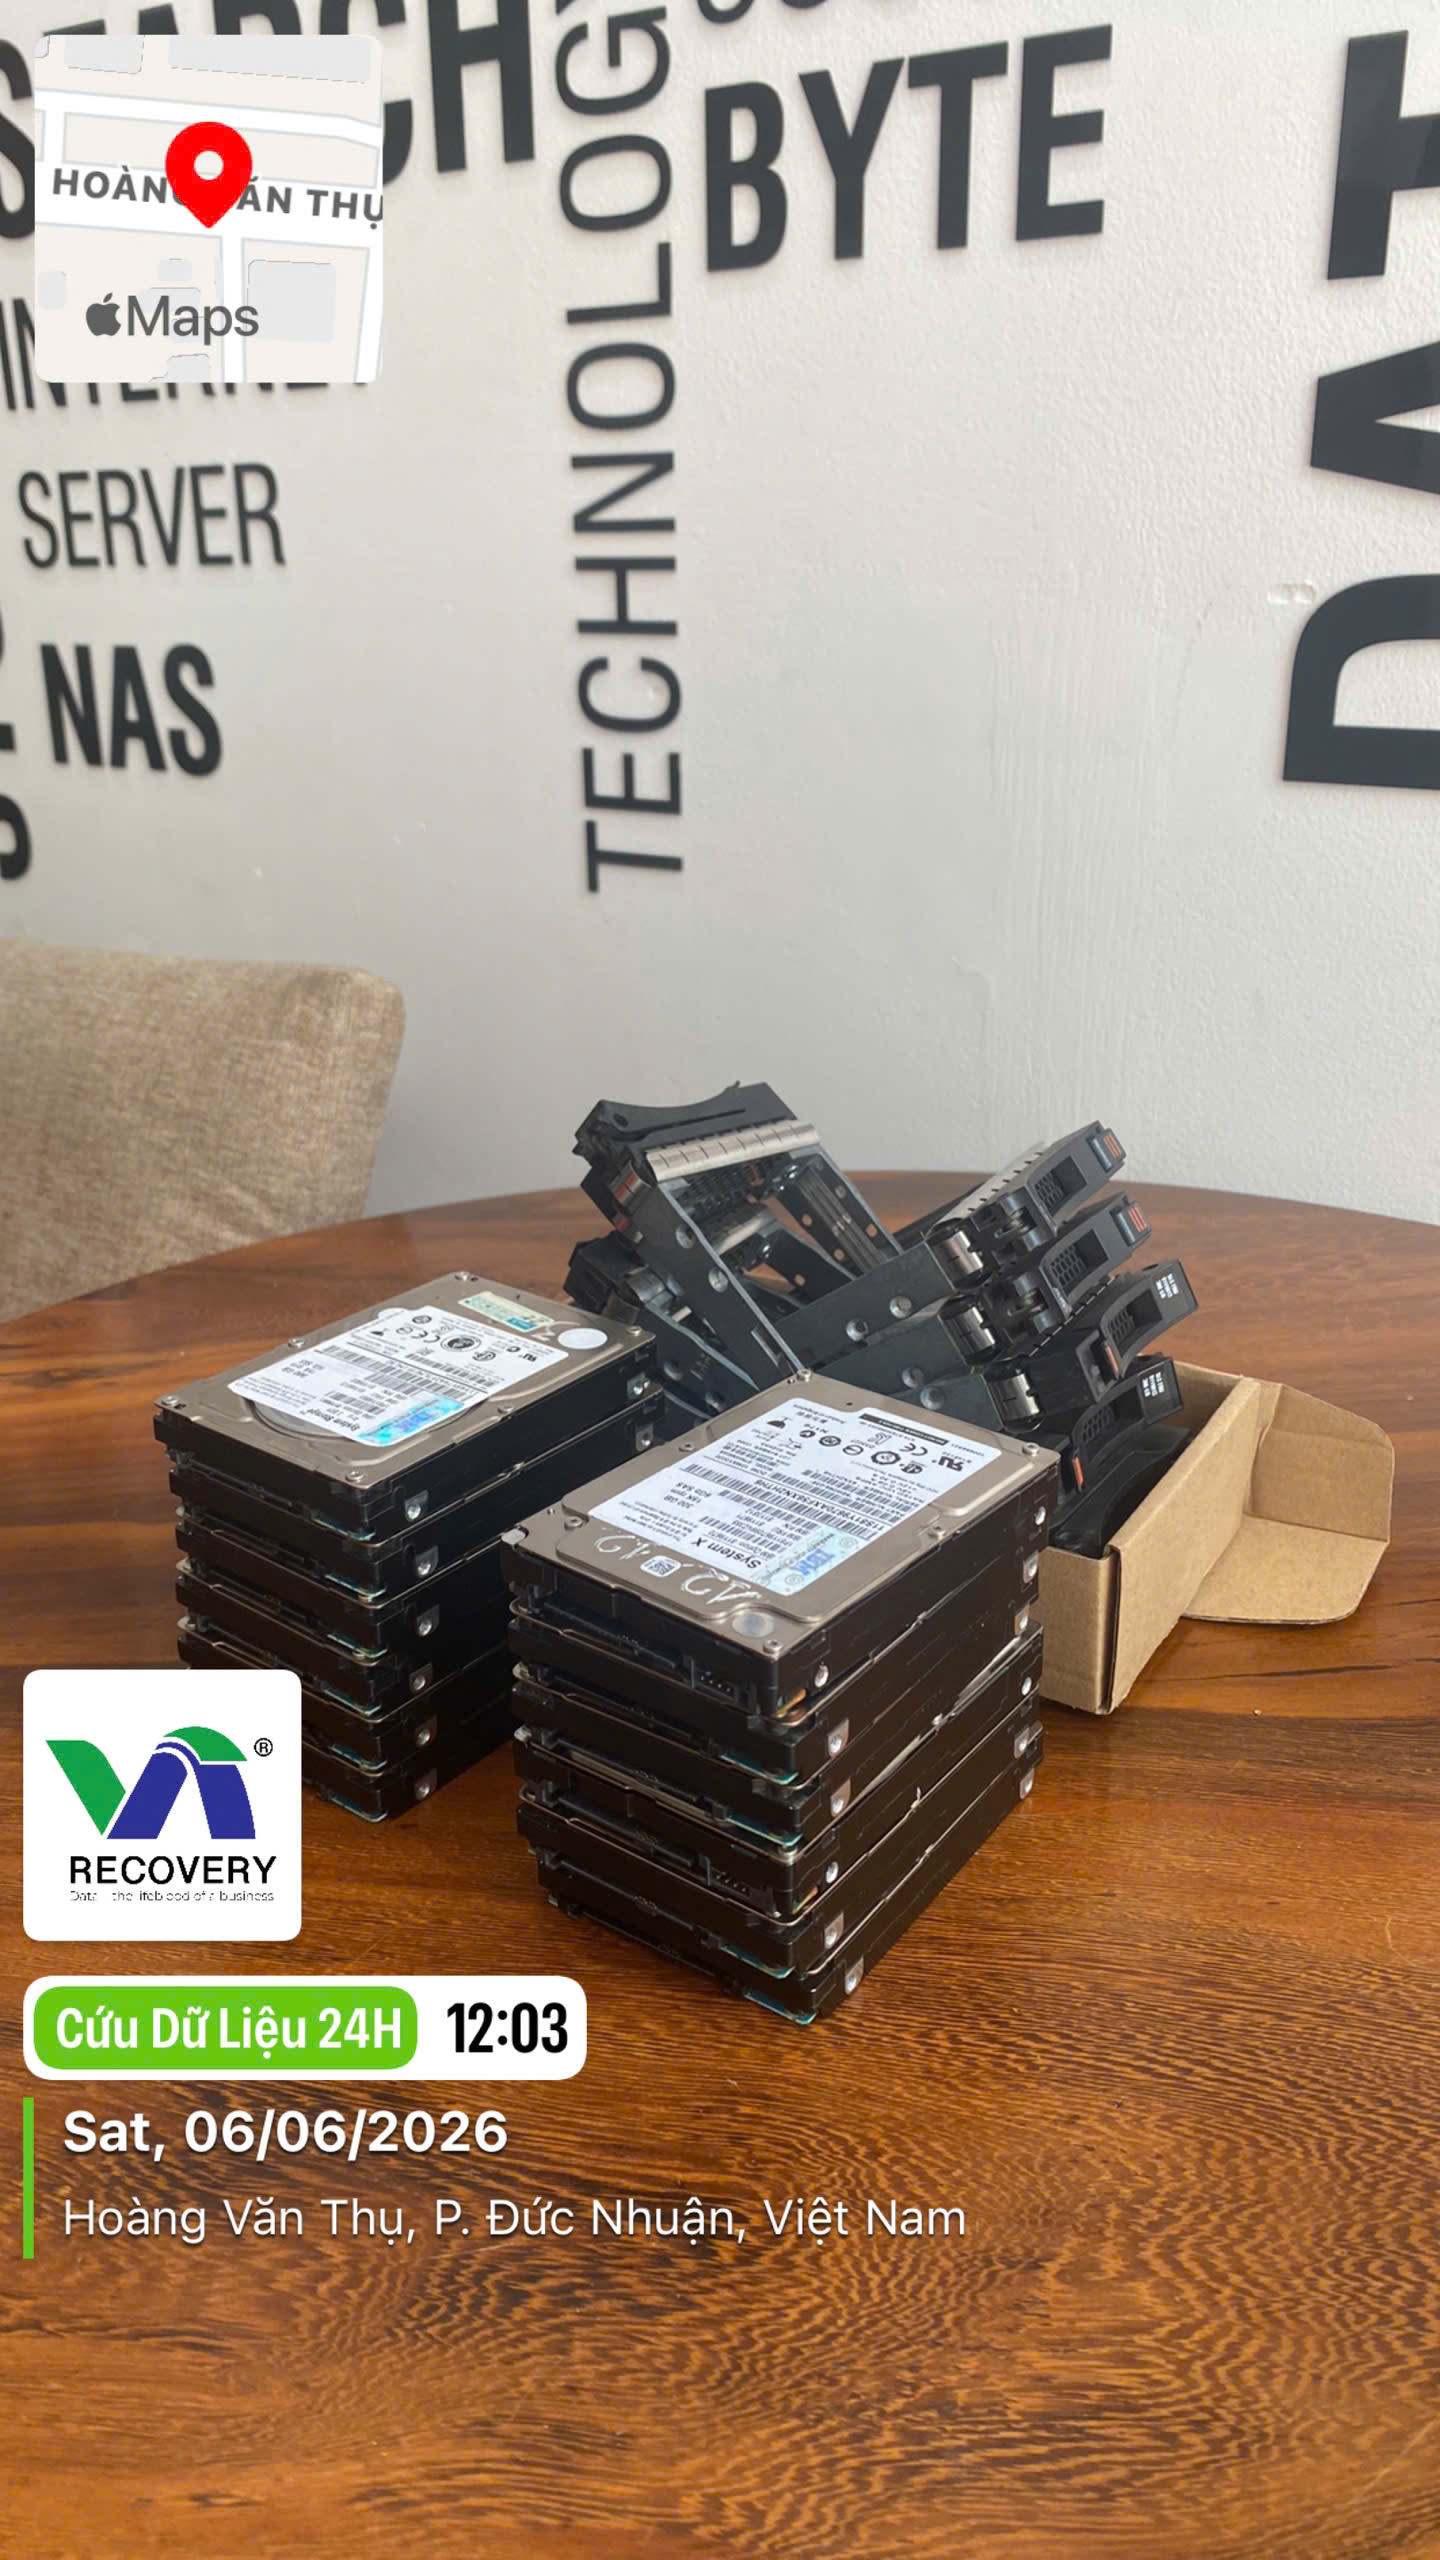
Case SAN DS3524 RAID 5 gồm 12 ổ SAS cho thấy dữ liệu doanh nghiệp thường nằm qua nhiều tầng kỹ thuật: ổ cứng vật lý, RAID, logical drive, VMFS và máy ảo.
Khi hệ thống SAN gặp sự cố, điều quan trọng nhất không phải là cố rebuild ngay, mà là giữ nguyên hiện trạng, kiểm tra từng ổ, tạo bản sao an toàn và dựng lại RAID trên môi trường phân tích.
Trong case này, việc dựng được RAID ảo và truy xuất được datastore DS_cluster là bước quan trọng để phục hồi dữ liệu máy ảo. Tuy nhiên, với dữ liệu VMware, kết quả cuối cùng luôn cần được xác minh ở cấp file VMDK, cấu hình máy ảo và dữ liệu ứng dụng bên trong.
Đối với các hệ thống SAN, NAS, RAID Server hoặc VMware, xử lý đúng ngay từ đầu là yếu tố quyết định khả năng phục hồi dữ liệu.
Hệ thống RAID / SAN / NAS của bạn gặp sự cố nhiều ổ?Đừng tự rebuild hay initialize — một thao tác sai là mất dữ liệu vĩnh viễn. Hãy để chuyên gia dựng lại mảng và đánh giá trước.
0917 756 775 · 0888 711 775
Khảo sát & báo khả năng phục hồi miễn phí · Hỗ trợ 24/7