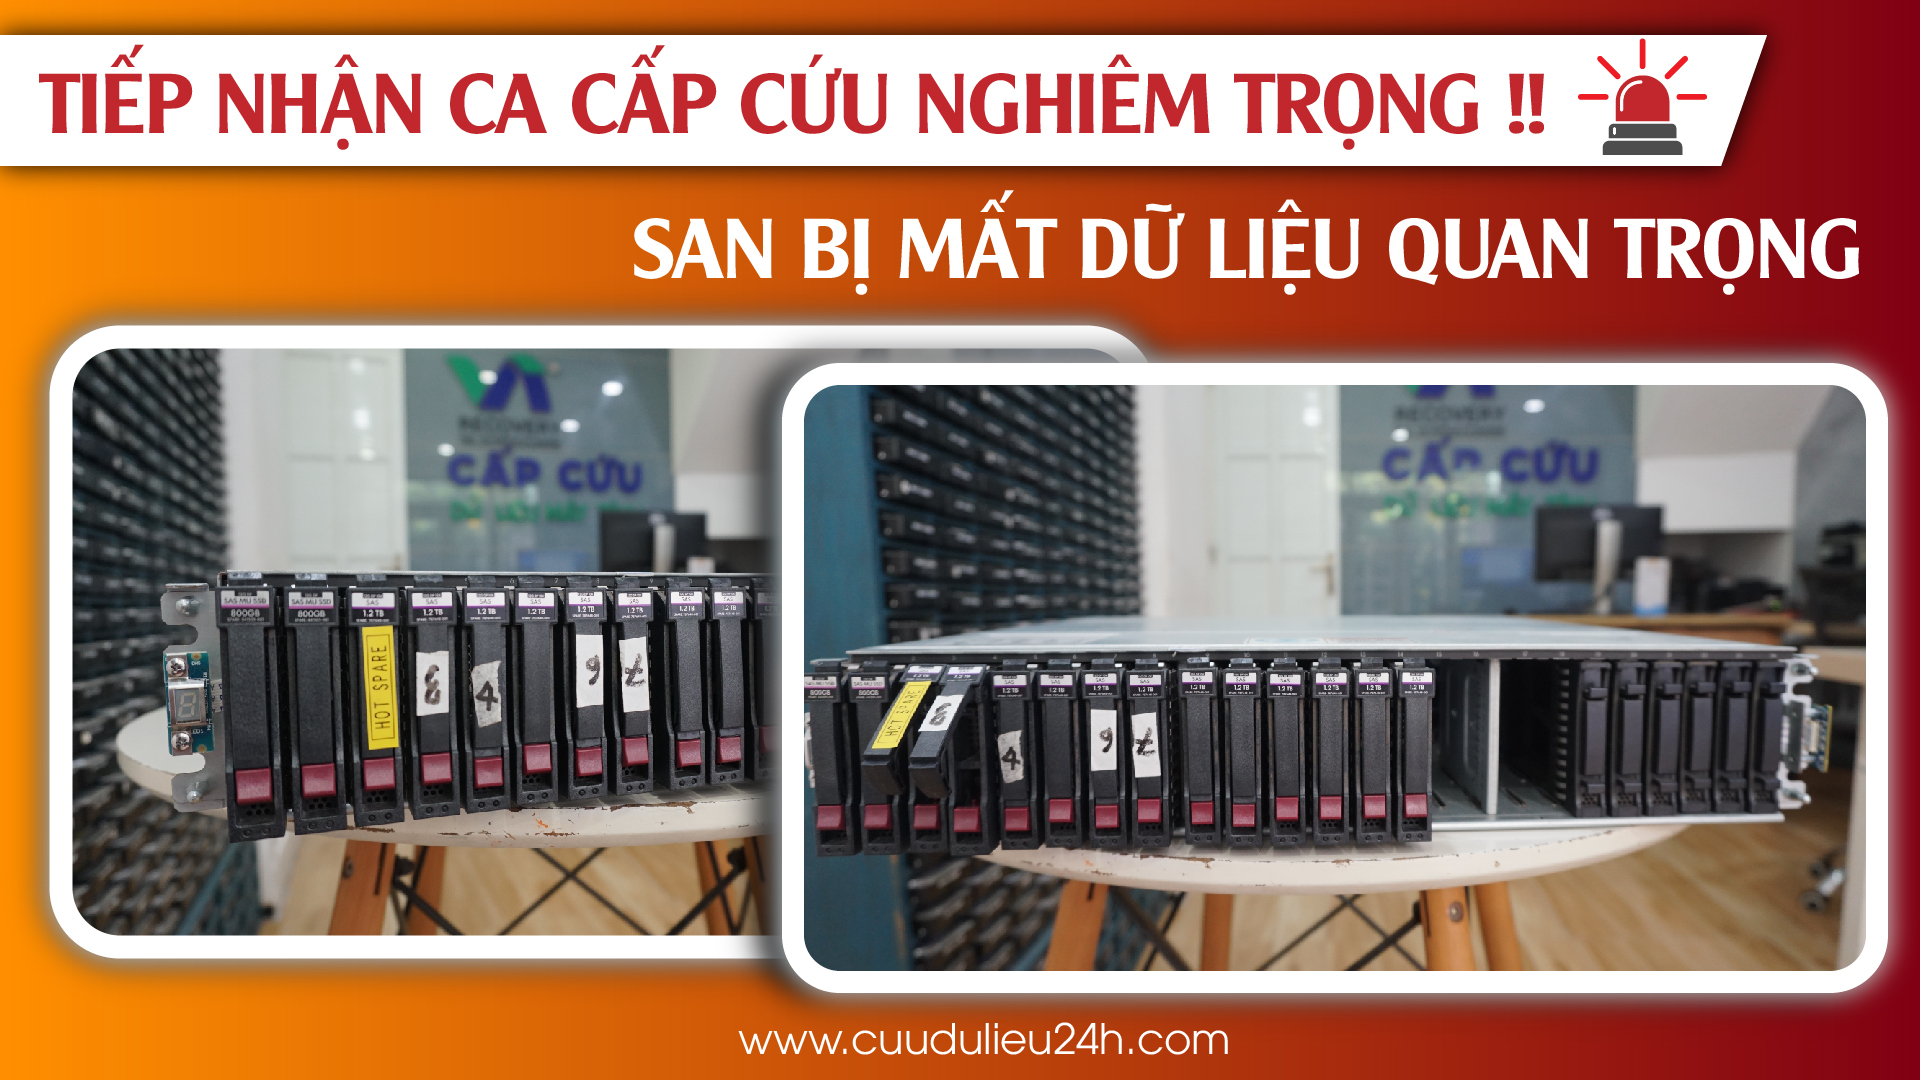
Hệ thống SAN Storage luôn được xem là “xương sống” của hạ tầng dữ liệu doanh nghiệp. Nhưng trong ca này, chính hệ thống được thiết kế để chịu lỗi cao lại rơi vào tình trạng nghiêm trọng nhất.
Doanh nghiệp liên hệ Cứu Dữ Liệu 24H trong trạng thái khẩn cấp:
Hệ thống SAN quan trọng phục vụ toàn bộ hoạt động sản xuất – vận hành đột ngột không thể truy cập dữ liệu.
Mảng RAID 6 gồm 11 ổ cứng và 1 ổ hot spare đã vượt quá số lượng ổ lỗi cho phép.
Toàn bộ dữ liệu trở nên “bất khả xâm phạm”.
Tóm tắt nhanh: Hệ thống SAN HPE MSA 2050 chạy RAID 6 (11 ổ + 1 hot spare) vượt ngưỡng chịu lỗi, toàn bộ dữ liệu không truy cập được. Cứu Dữ Liệu 24H đã phân tích, tái tạo cấu trúc RAID và phục hồi dữ liệu đầy đủ — đưa doanh nghiệp vận hành trở lại.
11+1
Ổ cứng (+ hot spare)
MSA 2050
Thiết bị SAN HPE
Tình huống đặc biệt nguy hiểm của RAID 6
RAID 6 cho phép mất đồng thời 2 ổ cứng mà dữ liệu vẫn an toàn.
Tuy nhiên, trong trường hợp này:
- Nhiều ổ cứng phát sinh lỗi gần như cùng thời điểm
- Hot spare đã được kích hoạt nhưng không đủ để cứu hệ thống
- RAID rơi vào trạng thái degraded nặng, không thể mount dữ liệu
Đây là tình huống hiếm nhưng cực kỳ nguy hiểm, nơi mà cơ chế bảo vệ của RAID 6 không còn phát huy tác dụng.
Vì sao nhiều ổ cứng lại hỏng gần như cùng lúc?
Đây là câu gần như ai cũng hỏi khi vừa gặp sự cố: “Cả dàn ổ mua cùng đợt, sao lại chết gần như một lượt?”. Thực tế chuyện này không hiếm như nhiều người nghĩ.
Các ổ trong một tủ đĩa thường cùng lô, cùng hãng, cùng số giờ chạy và cùng điều kiện nhiệt độ. Khi một ổ bắt đầu yếu, những ổ còn lại cũng đã ở ngưỡng tuổi thọ tương tự. Lúc hệ thống rebuild để thay ổ hỏng, các ổ còn lại phải đọc toàn bộ dữ liệu ở cường độ cao suốt nhiều giờ — và chính lúc đó, ổ yếu tiếp theo dễ gục.
Nói cách khác: RAID không giúp bạn tránh việc cả dàn ổ già đi cùng nhau. Nó chỉ mua thêm thời gian — và thời gian đó sẽ hết nếu không ai để ý.
Thách thức kỹ thuật ở mức rất cao
Sự cố này trước đó đã được khách hàng chuyển sang một đơn vị khác để xử lý. Tuy nhiên, sau hơn 30 ngày can thiệp, đơn vị này buộc phải thông báo không thể khôi phục dữ liệu. Thực tế cho thấy đây là một ca sự cố cực kỳ phức tạp, với mức độ khó cao, đặt đội ngũ Cứu Dữ Liệu 24H trước hàng loạt thách thức kỹ thuật lớn ngay từ những bước đánh giá ban đầu.
- Nhiều ổ cứng cùng lỗi không thể rebuild tự động
- Dung lượng dữ liệu cực lớn: mỗi ổ ~1.2TB, tổng dữ liệu lên đến hàng chục terabyte
- Cấu hình SAN phức tạp với model đặc thù như FCLSE-0801 MSA2050, có cơ chế hoạt động và metadata riêng
- Chỉ cần một thao tác sai (rebuild, reset, initialize…) là mất dữ liệu vĩnh viễn
Đây không còn là bài toán “cứu ổ cứng”, mà là phục dựng lại toàn bộ cấu trúc lưu trữ cấp doanh nghiệp.
Một giờ đầu quyết định cứu được bao nhiêu
Trong phần lớn ca SAN/RAID chúng tôi nhận, dữ liệu mất thêm không đến từ sự cố ban đầu, mà đến từ những thao tác “chữa cháy” vội vàng sau đó. Khi hệ thống báo lỗi, phản xạ tự nhiên là muốn làm gì đó ngay. Nhưng với mảng đã vượt ngưỡng chịu lỗi, mỗi thao tác sai là một lần ghi đè không lấy lại được.
Bốn việc nên dừng lại ngay:
- Đừng bấm Rebuild / Repair nhiều lần. Rebuild trên mảng đã lỗi nặng có thể ghi đè chính phần dữ liệu còn đọc được.
- Đừng Initialize, Reset cấu hình hay “Create new array”. Những lệnh này xoá bảng cấu trúc RAID — thứ quyết định việc ghép lại dữ liệu về sau.
- Đừng rút ra cắm lại ổ theo thứ tự ngẫu nhiên. Thứ tự ổ trong mảng là một phần của dữ liệu; đảo lộn khiến việc tái tạo khó hơn nhiều.
- Đừng cho hệ thống chạy tiếp và ghi dữ liệu mới. Mỗi lần ghi là một lần đè lên vùng có thể còn cứu được.
Việc đúng nhất lúc này lại rất đơn giản: tắt hệ thống, giữ nguyên hiện trạng ổ đĩa và gọi đơn vị có kinh nghiệm. Giữ nguyên hiện trạng luôn là lựa chọn an toàn nhất.
Quy trình xử lý: đi chậm – đúng – tuyệt đối an toàn
Đội ngũ kỹ thuật triển khai quy trình khôi phục SAN chuyên sâu:
Đánh giá tình trạng tổng thể
- Kiểm tra từng ổ cứng để xác định mức độ hư hỏng
- Phân loại lỗi: logic – firmware – vật lý
Xử lý ổ cứng lỗi trong phòng sạch Class 100
- Can thiệp phần cứng với tiêu chuẩn cao
- Đảm bảo không phát sinh hư hỏng thứ cấp
Phân tích & tái tạo cấu trúc RAID 6
- Xác định thứ tự ổ đĩa
- Thuật toán parity kép
- Vai trò của ổ hot spare
- Xử lý lỗi parity phức tạp để đảm bảo tính toàn vẹn dữ liệu
Trích xuất & khôi phục dữ liệu
- Đọc – sao chép dữ liệu từ mảng RAID đã tái tạo
- Kiểm tra lỗi phát sinh
- Khôi phục dữ liệu về đúng cấu trúc, đúng định dạng gốc
Áp lực lớn nhất: dữ liệu gắn liền với hoạt động doanh nghiệp
Trong suốt quá trình xử lý:
- Doanh nghiệp bị gián đoạn vận hành
- Mọi quyết định kỹ thuật đều ảnh hưởng trực tiếp đến hoạt động kinh doanh
- Không có chỗ cho thử nghiệm hay “làm lại từ đầu”
- Đây là nơi kinh nghiệm thực chiến và quy trình bài bản tạo ra sự khác biệt.
Kết quả: dữ liệu được phục hồi – doanh nghiệp hoạt động trở lại
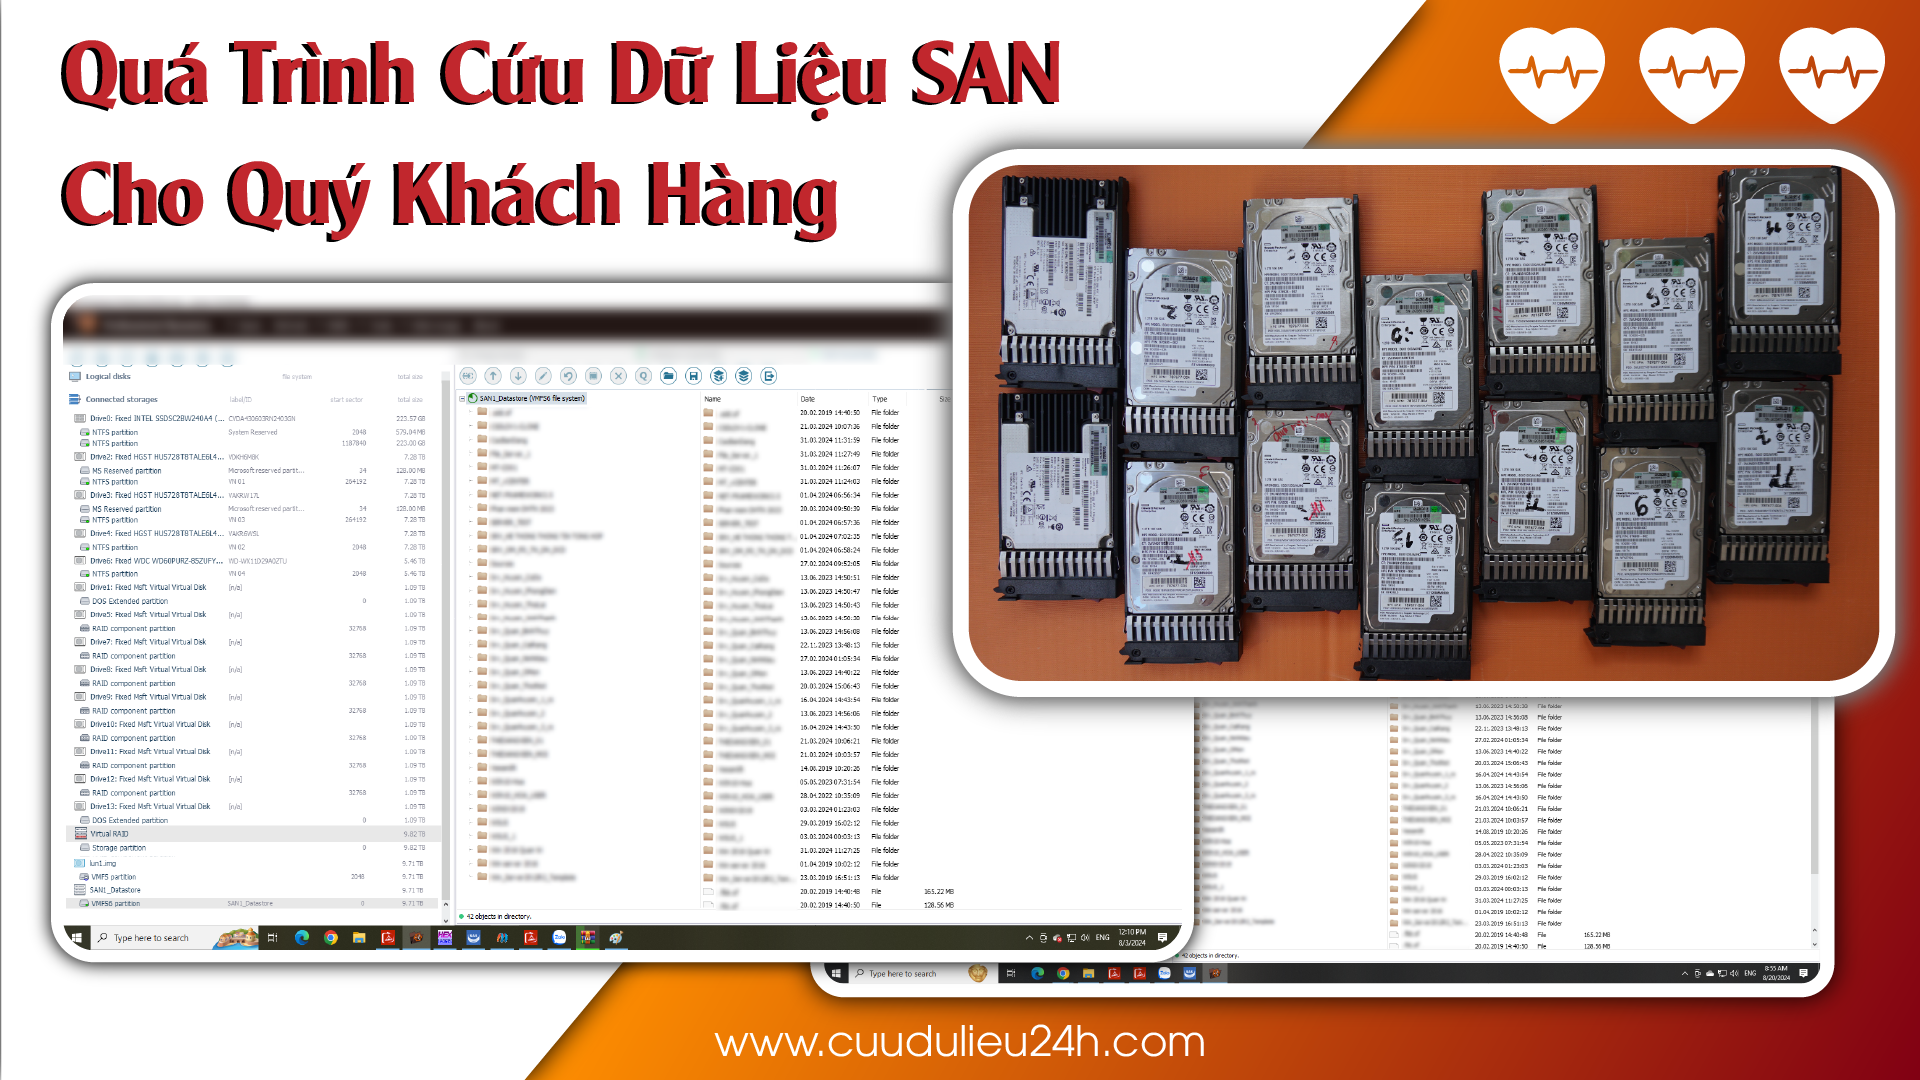
Sau khi hoàn tất toàn bộ quy trình:
- Dữ liệu SAN được khôi phục đầy đủ
- Tính toàn vẹn và khả năng sử dụng được đảm bảo
- Doanh nghiệp nhanh chóng ổn định và tiếp tục vận hành
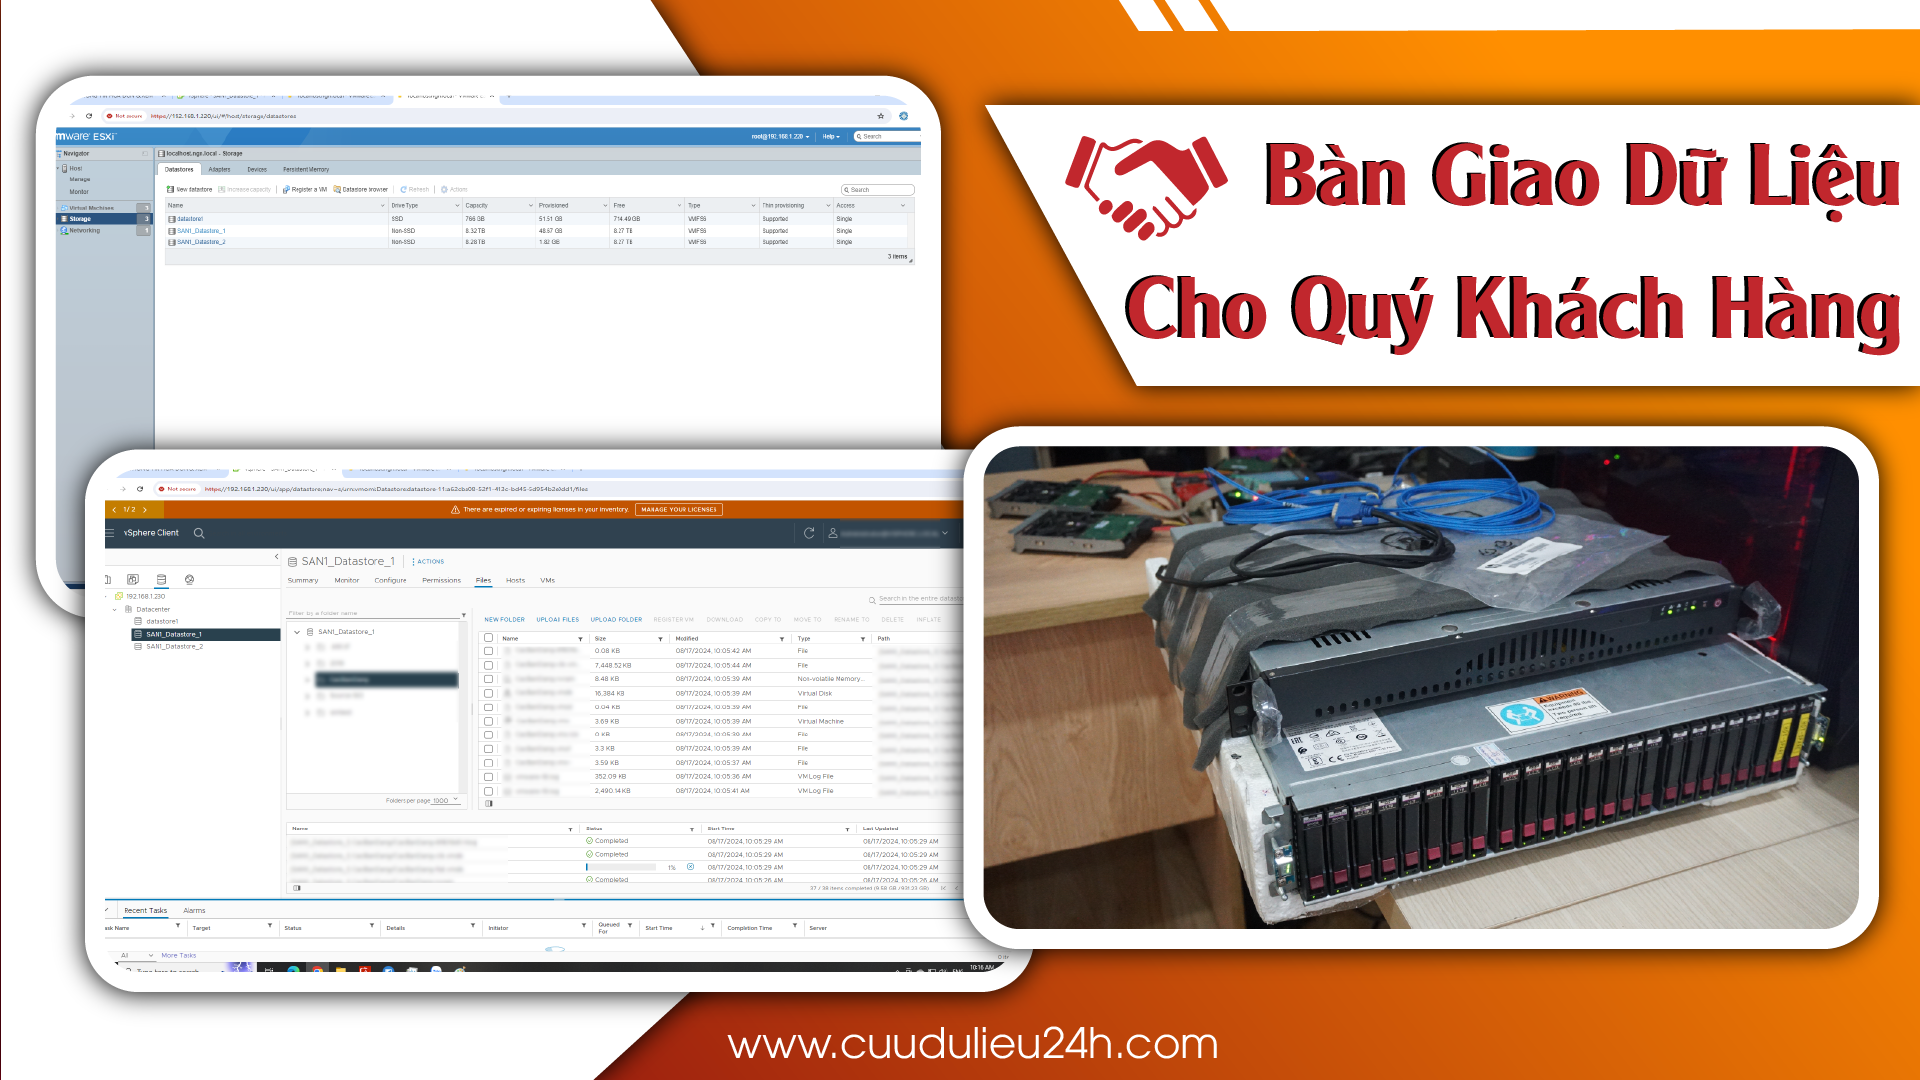
Một ca RAID 6 vượt ngưỡng chịu lỗi – tưởng chừng không còn khả năng cứu – đã được xử lý thành công.
Tự khôi phục hay gọi đơn vị chuyên nghiệp?
Với một ổ đơn lẻ, đôi khi bạn tự xoay xở được bằng phần mềm. Nhưng SAN/RAID là chuyện khác hẳn. Dữ liệu nằm rải trên nhiều ổ theo một quy tắc riêng, cộng thêm lớp cấu hình riêng của từng hãng (như MSA 2050). Phần mềm phổ thông không hiểu được lớp này, và mỗi lần thử sai trên dữ liệu gốc là một lần rủi ro.
Đơn vị chuyên nghiệp khác ở ba điểm: luôn làm trên bản sao chứ không đụng ổ gốc, có phòng sạch để xử lý ổ hỏng phần cứng mà không gây hư hại thứ cấp, và có kinh nghiệm đọc đúng cấu trúc của từng dòng thiết bị. Khi dữ liệu là sổ sách, hồ sơ hay cả hoạt động của công ty, cái giá của một lần thử sai thường lớn hơn nhiều so với chi phí làm đúng ngay từ đầu.
Làm gì để lần sau không rơi vào tình huống này?
Khôi phục xong, câu hỏi tiếp theo luôn là: làm sao để không lặp lại? Vài việc đơn giản nhưng tạo khác biệt lớn:
- Đừng xem RAID là bản sao lưu. RAID giúp chạy liên tục khi một ổ hỏng, nhưng không cứu bạn khỏi lỗi nhiều ổ, xoá nhầm hay mã hoá. Sao lưu phải là bản tách rời, nằm ở nơi khác.
- Thay ổ theo tuổi thọ, đừng đợi hỏng. Nếu cả dàn mua cùng đợt, nên lên kế hoạch luân phiên thay trước khi chúng cùng già.
- Theo dõi cảnh báo của tủ đĩa. Phần lớn hệ thống báo “ổ sắp yếu” từ sớm. Một ổ degraded bị bỏ qua vài tuần là công thức dẫn tới mất dữ liệu.
- Kiểm tra bản sao lưu định kỳ. Một bản backup chưa từng thử phục hồi thì chưa chắc đã là bản backup.
Câu hỏi thường gặp
RAID 6 mất hơn 2 ổ thì còn cứu được không?
Nhiều trường hợp vẫn cứu được, kể cả khi số ổ lỗi vượt ngưỡng lý thuyết — miễn là hiện trạng ổ đĩa được giữ nguyên, chưa bị rebuild hay initialize đè lên. Đánh giá chính xác cần kiểm tra trực tiếp.
Mất bao lâu để khôi phục một hệ thống SAN?
Tuỳ số lượng ổ, mức độ hư hỏng phần cứng và dung lượng. Có ca xong trong vài ngày, có ca lâu hơn khi phải xử lý ổ lỗi vật lý trong phòng sạch. Chúng tôi luôn khảo sát và báo trước phạm vi dữ liệu có thể lấy lại.
Dữ liệu của tôi có bị lộ ra ngoài không?
Không. Toàn bộ xử lý trong nội bộ, dữ liệu bàn giao lại cho khách và xoá theo yêu cầu sau khi hoàn tất.
Nếu không lấy lại được thì sao?
Chúng tôi khảo sát và báo khả năng trước khi làm, để bạn nắm rõ tình huống trước khi quyết định — không có chi phí bất ngờ.
Hệ thống SAN / RAID của bạn gặp sự cố?Đừng tự rebuild hay initialize — một thao tác sai là mất dữ liệu vĩnh viễn. Hãy gọi chuyên gia ngay.
0917 756 775 · 0888 711 775
Khảo sát miễn phí · Hỗ trợ 24/7